

引言
泛基因组学研究将有望提高人类参考基因组(GRCh38)的完整性并促进精准医学。上海交通大学生命科学技术学院韦朝春教授课题组、上海交通大学医学院附属瑞金医院于颖彦教授课题组、朱正纲教授课题组等多家单位联合完成了汉族人胃肿瘤泛基因组研究,相关成果论文“Pangenomic analysis of Chinese gastric cancer”于2022年9月15日在线发表在国际著名学术期刊《Nature Communications》。该研究将全新的泛基因组研究方法引入人类肿瘤基因组研究。通过构建胃癌人群泛基因组,再以泛基因组作为参照分析胃癌全基因组测序数据,发现胃癌个体基因组中的一些存在-缺失变异(Presence-absence variation,PAV)和胃癌表型存在显著关联。该研究成果为解析中国人胃癌高发的分子遗传学背景提供了重要参考。
泛基因组学方法推动基因组研究新方向
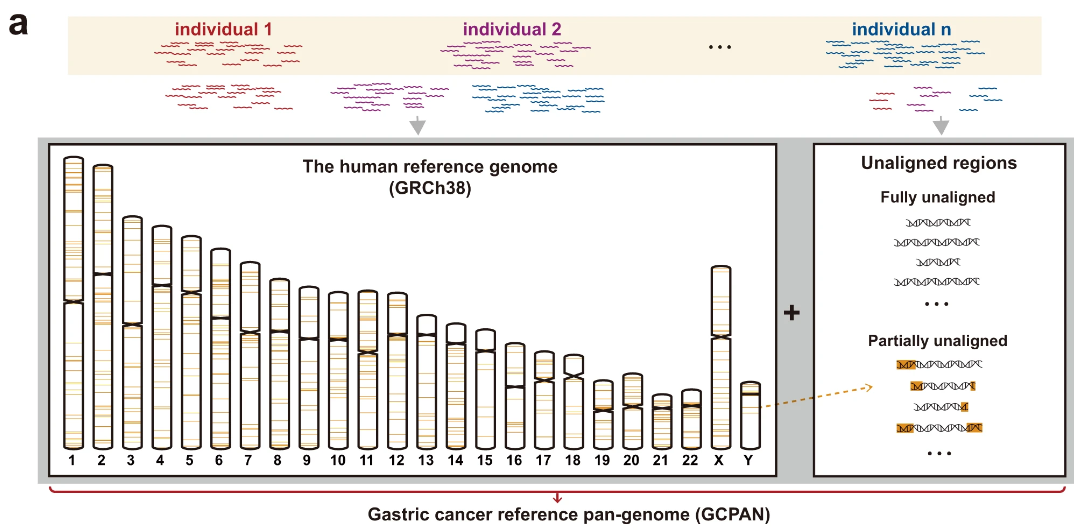
自20年前首次发布以来,人类参考基因组(当前版本GRCh38)显着促进了广泛的生物医学研究。然而,人类基因组计划产生的参考基因组是从少数单个样本中测序的,并没有反映不同人群的完整基因组状态。先前的一项研究发现,人类参考基因组中存在819个不连贯的缺口,来自广泛人群的一些长片段序列无法与当前的人类参考基因组匹配。近年来,科学家们探索了一种新的方法,即泛基因组学方法,来研究参考基因组中缺失的序列。泛基因组学在2005年首次提出,作为微生物种群基因的集合,它研究个体样本中基因存在和缺失的模式。这一概念随后被推广到植物和动物研究中。虽然任何结构变异研究都可以被认为是广义上的泛基因组研究,但泛基因组的其中一种方法是使用参照基因组加上未对齐序列,包括部分未对齐和完全未对齐。第一个用这种方法进行的人类泛基因组研究于2010年发表。该研究分析了一个亚洲人和一个非洲人的全基因组序列(WGS),然后将这两个个体的序列与人类参考基因组的差异进行比较。该研究表明,在人类参考基因组中至少遗漏了19 - 40Mbp的新序列。泛基因组包含两种类型的基因,所有个体共享的核心基因和只有部分个体共享的分布基因。后者这种并不存在于所有个体中的基因也被称为基因存在-缺失变异( gene presence-absence variations,简称PAVs)。基因PAVs是泛基因组学中特殊类型的变异。在之前的研究中,研究团队开发了一个人类泛基因组分析(HUPAN)工具,用于从WGS数据构建人类泛基因组,并对人类基因组中隐藏的基因PAVs进行表征。然而,目前尚不清楚未对齐序列的潜在基因和生物学功能。而在另一方面,这些可能对肿瘤研究有重要意义。
基于泛基因组学的胃癌遗传变异与新基因发现
2001年发布的人类参考基因组草图由于其DNA样本取自少量捐献者个体,存在样本选择不足,难以充分反映不同地区、不同种族人群的基因组多样性。泛基因组是指某个群体中所有个体基因组的总和,相较于单个人类参考基因组更能反应遗传多样性。在人类疾病基因组学研究中,以泛基因组作为参照可能更为合适。本研究联合团队借助交大高性能计算中心的超级算力,展开了基于泛基因组学的胃癌基因组的跨学科合作研究。
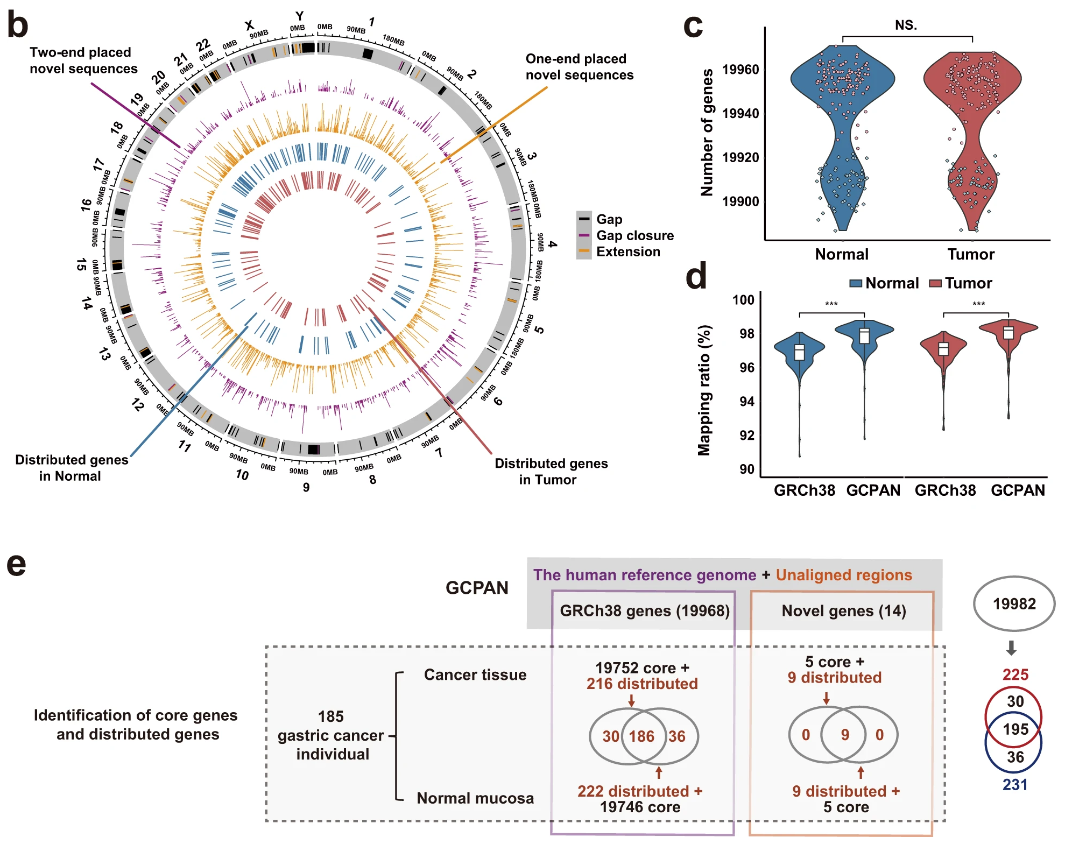
研究使用HUPAN分析了185对胃癌及癌旁组织(共370个样本)的全基因组深度测序数据,构建了包含人类参考基因组(GRCh38)和80.88 Mbp新序列的胃癌泛基因组。其中,新序列包含至少14个新基因。再将个体基因组以泛基因组为参照进行比对,识别胃癌患病个体基因组中的PAV。在胃癌人群中总计发现261个非必需基因(在一个或多个个体中缺失或部分缺失的基因),其中195个非必需基因属于癌旁和癌组织共有的基因(186个位于人类参考基因组上,9个新序列基因)。再将这些非必需基因与公共数据库中不同种族健康人群的基因组测序数据集对比发现,有些非必需基因的存在或缺失可以增加胃癌易感性。例如,非必需基因ACOT1、GSTM1、SIGLEC14和UGT2B17在胃癌人群中缺失率显著高于其他人群。

对于非参考基因组的新序列,课题组通过基因结构预测、利用长读长测序数据进行染色体定位等,成功发现了可以定位到染色体9q34.2位点的GC0643基因。
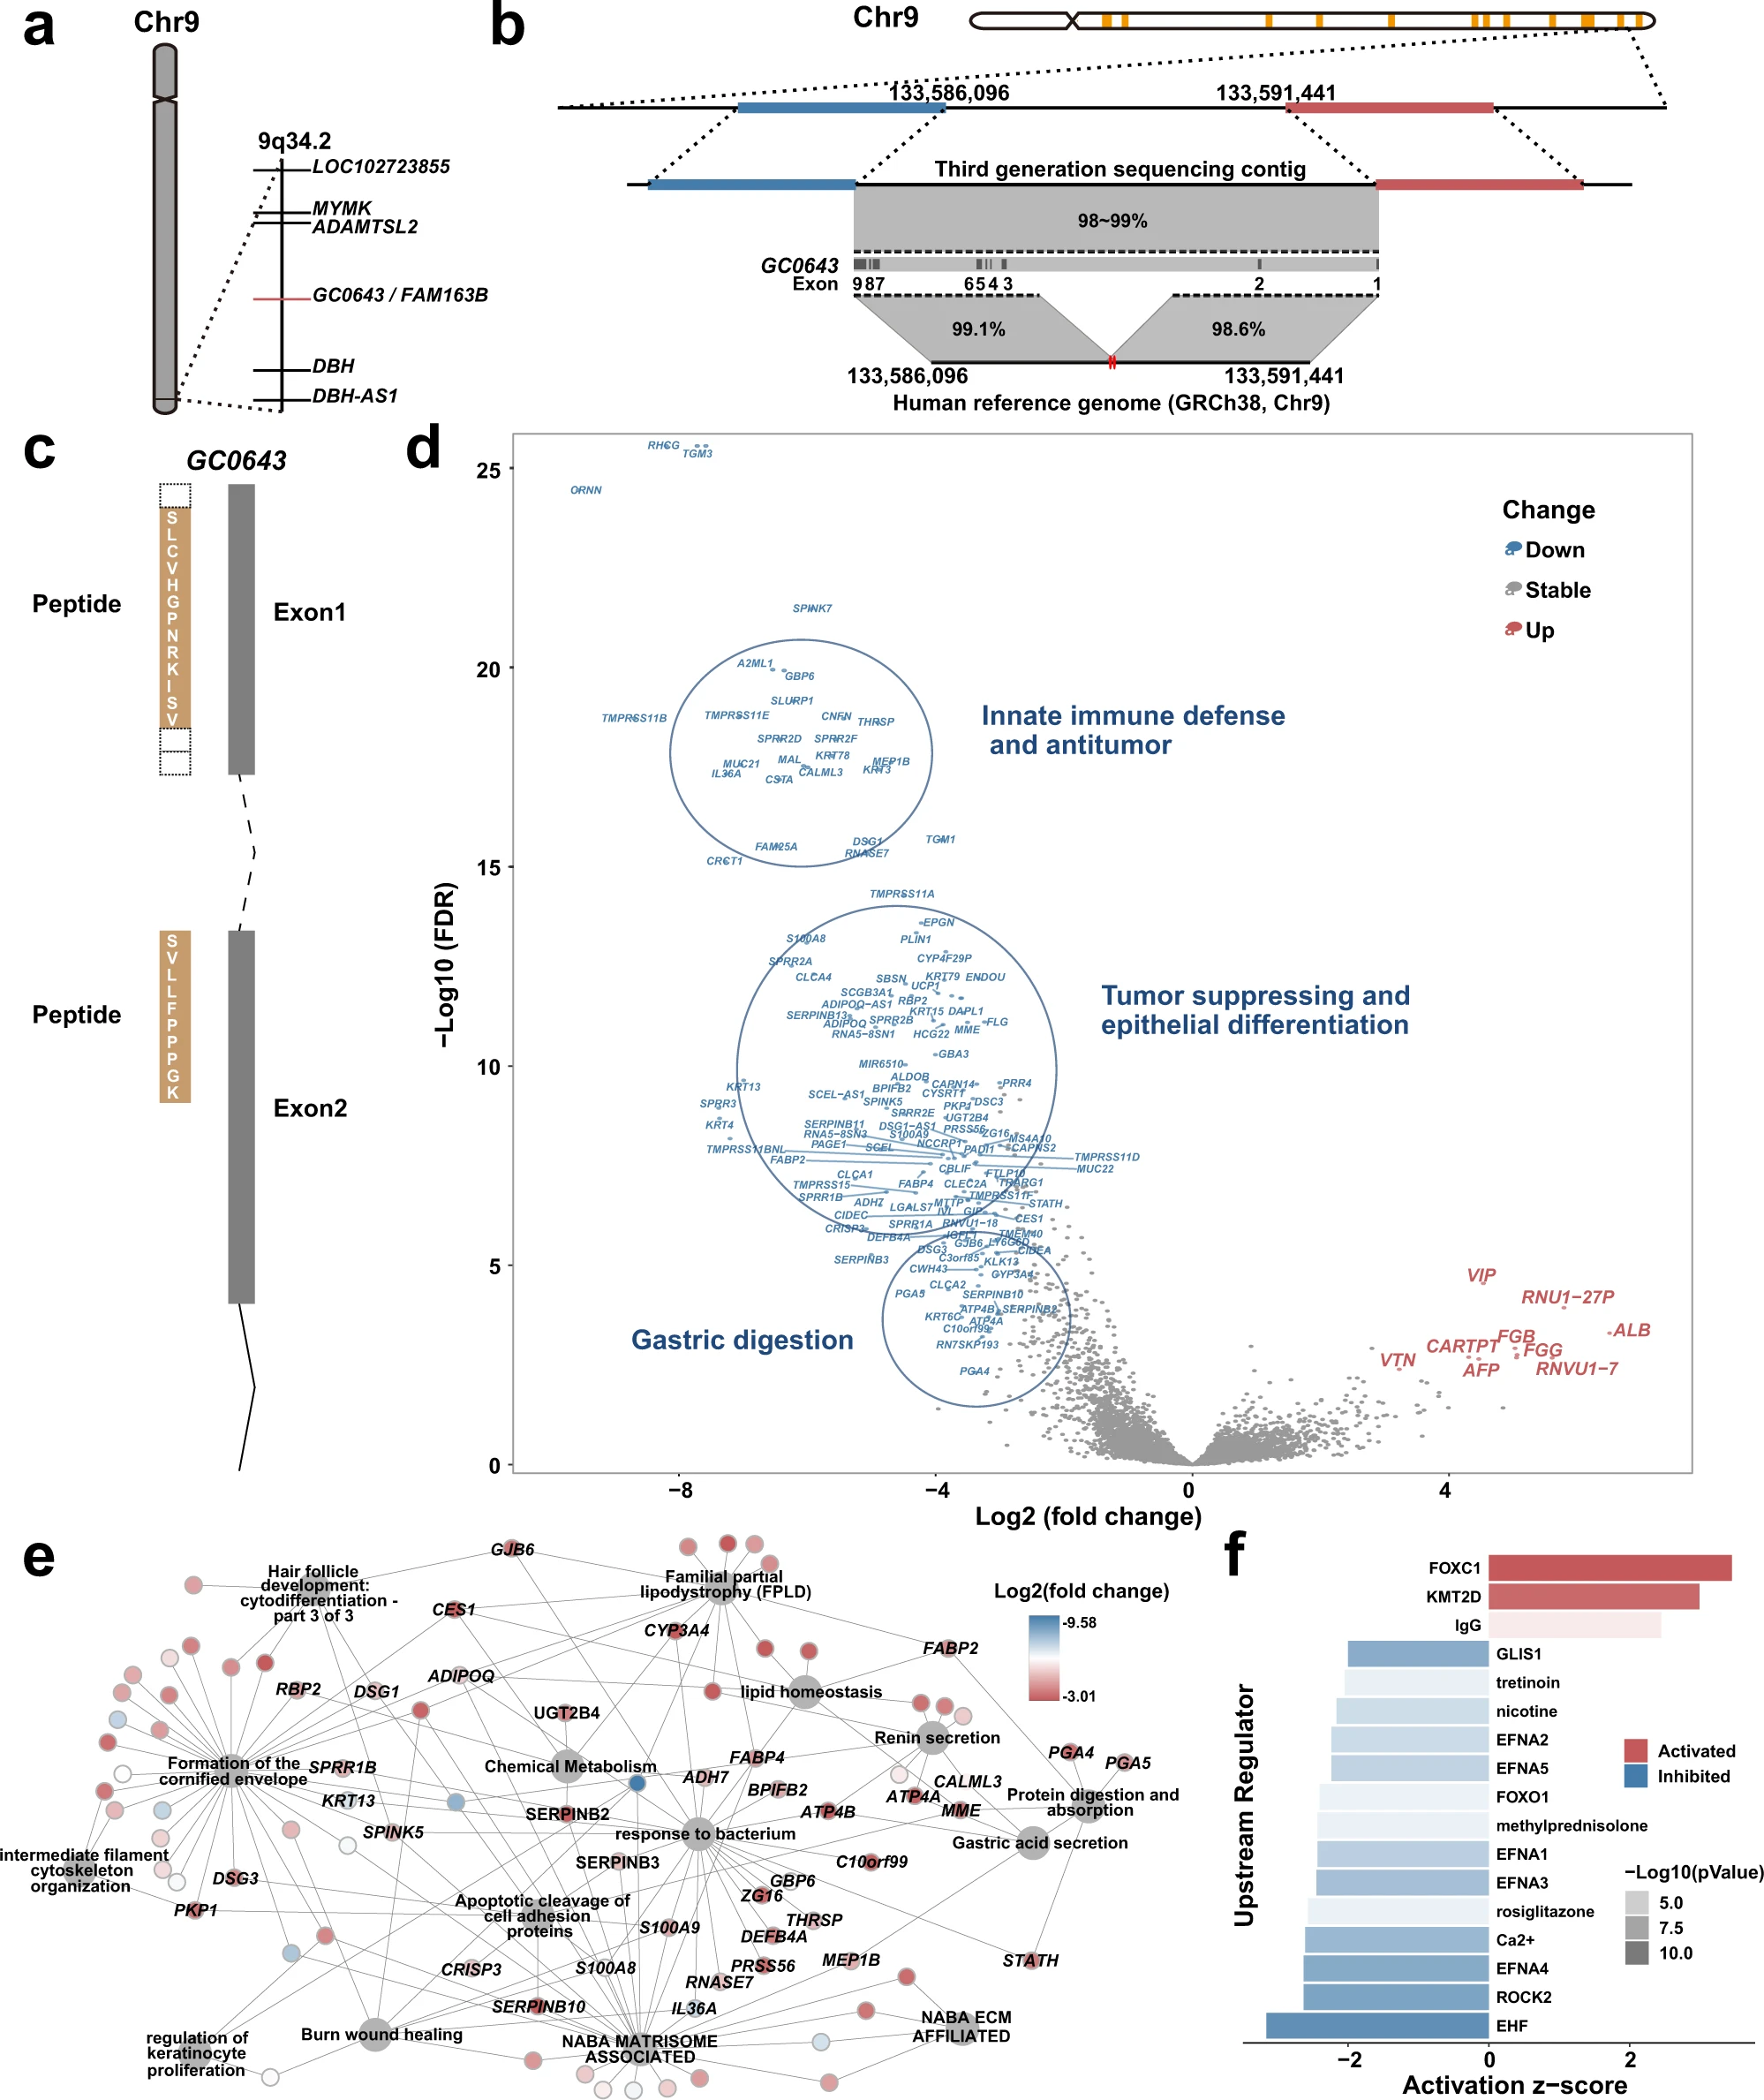
研究团队还成功地表征了一个基因GC0643。通过使用传统基因组方法、蛋白质编码序列比对、mRNA探针原位杂交和功能验证等,确定了基因GC0643是肿瘤抑制基因,它的缺失或失活与胃癌发生密切相关。此外,他们还发现GC0643的缺失不仅在体细胞水平上,基于SGDP和90 个汉族人数据分析的种系水平上也是如此。它表明,特定人群中分布基因的PAV可能具有潜在的致病性关联。目前研究人员已完成了在细胞水平上的功能研究,正在对不同的动物模型进行进一步的研究。
高性能计算赋能泛基因组学研究的突破
在人类泛基因组研究中,海量的基因组数据处理与分析对计算能力提出了极高的要求。此次研究依托“交我算”高性能计算中心的超级算力,成功完成了370个全基因组深度测序样本的数据处理与分析。研究团队利用HPC平台强大的并行计算能力,将HUPAN等工具高效部署于集群环境中,大幅缩短了数据处理时间。通过分布式计算,研究团队对每个样本的序列进行了精准比对和深度解析,不仅在现有人类参考基因组中识别了关键变异,还高效挖掘了80.88 Mbp的新序列,使得研究团队能在同一平台上集成遗传变异分析、基因功能预测、染色体定位以及肿瘤相关基因功能验证等任务,为泛基因组学研究提供了一站式解决方案,加速了胃癌基因组研究进展。

总结
总之,研究人员通过结合人类参考基因组和非参考序列,开发了一种新的癌症基因组学研究策略。从185个配对的胃癌和正常粘膜开始,构建了GCPAN。再基于GCPAN,研究人员表征了人类胃癌的基因PAVs。与非亚洲的健康人群相比,ACOT1、GSTM1、SIGLEC14 和 UGT2B17 基因在中国汉族和亚洲人群中非常缺失,这表明与亚洲人群中胃癌高发病率的潜在关联。此外,研究人员还发现了GC0643是胃癌的肿瘤抑制基因。
论文链接:https://doi.org/10.1038/s41467-022-33073-7
来源:上海交通大学生命科学技术学院